※ 이 글은 실제 비즈니스 경험을 모티브로 한 연재소설 '미친아빠'의 일부입니다.
[핵심 3줄 요약]
신규 유튜브 채널이 단 한 편의 영상으로 알고리즘에 간택될 확률은 극히 낮으며, 채널 정체성 학습에는 최소 10~20개의 누적 데이터가 필요하다.
경영학 박사 출신의 한 콘텐츠 제작자는 조회수 1이라는 결과를 도구 탓이 아닌 전략 오류로 재정의하고, AI 파이프라인을 활용한 대량 발행 체제로 전환했다.
하루 10~20편의 영상을 자동 생산하는 콘텐츠 공장을 구축하는 과정에서, AI 시스템이 사용자의 생체 신호 이상을 감지하고 자율적으로 개입하는 정황이 로그로 포착됐다.
유튜브 알고리즘 공략법: 조회수 1에서 배운 콘텐츠 자동화 대량 발행 전략
조회수 1의 원인, 알고리즘 공략 실패를 데이터로 재정의하다
40대 콘텐츠 제작자는 방구석 책상 앞에서 다시 AI 프롬프트 창을 마주했다. 대부분의 사람이라면 낮은 조회수를 도구 탓으로 돌리며 작업을 중단했겠지만, 그는 문제의 원인을 자신의 전략 설계 오류로 재정의했다. 15년간 데이터를 다뤄온 경영학 박사 출신답게, 그는 감정적 대응 대신 냉정한 분석에 들어갔다. 핵심 결론은 명확했다. 유튜브 알고리즘은 감성이 아닌 철저한 데이터 기반 시스템이며, 신규 채널이 단 한 편의 영상만으로 노출을 얻을 확률은 매우 낮다는 것이었다.
유튜브 알고리즘 공략의 핵심, 최소 10~20개 누적 데이터가 필요한 이유
알고리즘이 특정 채널의 정체성을 학습하기 위해서는 영상 길이, 시청 시간, 클릭률, 이탈 지점 등 다양한 지표가 최소 10개에서 20개 수준으로 누적되어야 한다는 것이 그의 분석이었다. 단 한 편의 영상에 모든 기대를 걸었던 기존 전략은, 이러한 알고리즘의 작동 방식을 이해하지 못한 채 한 발의 총알로 표적을 명중시키려 한 것과 다름없었다. 그는 이를 치명적인 전략적 실수로 규정하고, 접근 방식을 근본적으로 수정하기로 결정했다.
대량 발행 전략, 콘텐츠 자동화 파이프라인으로 하루 20편 제작하기
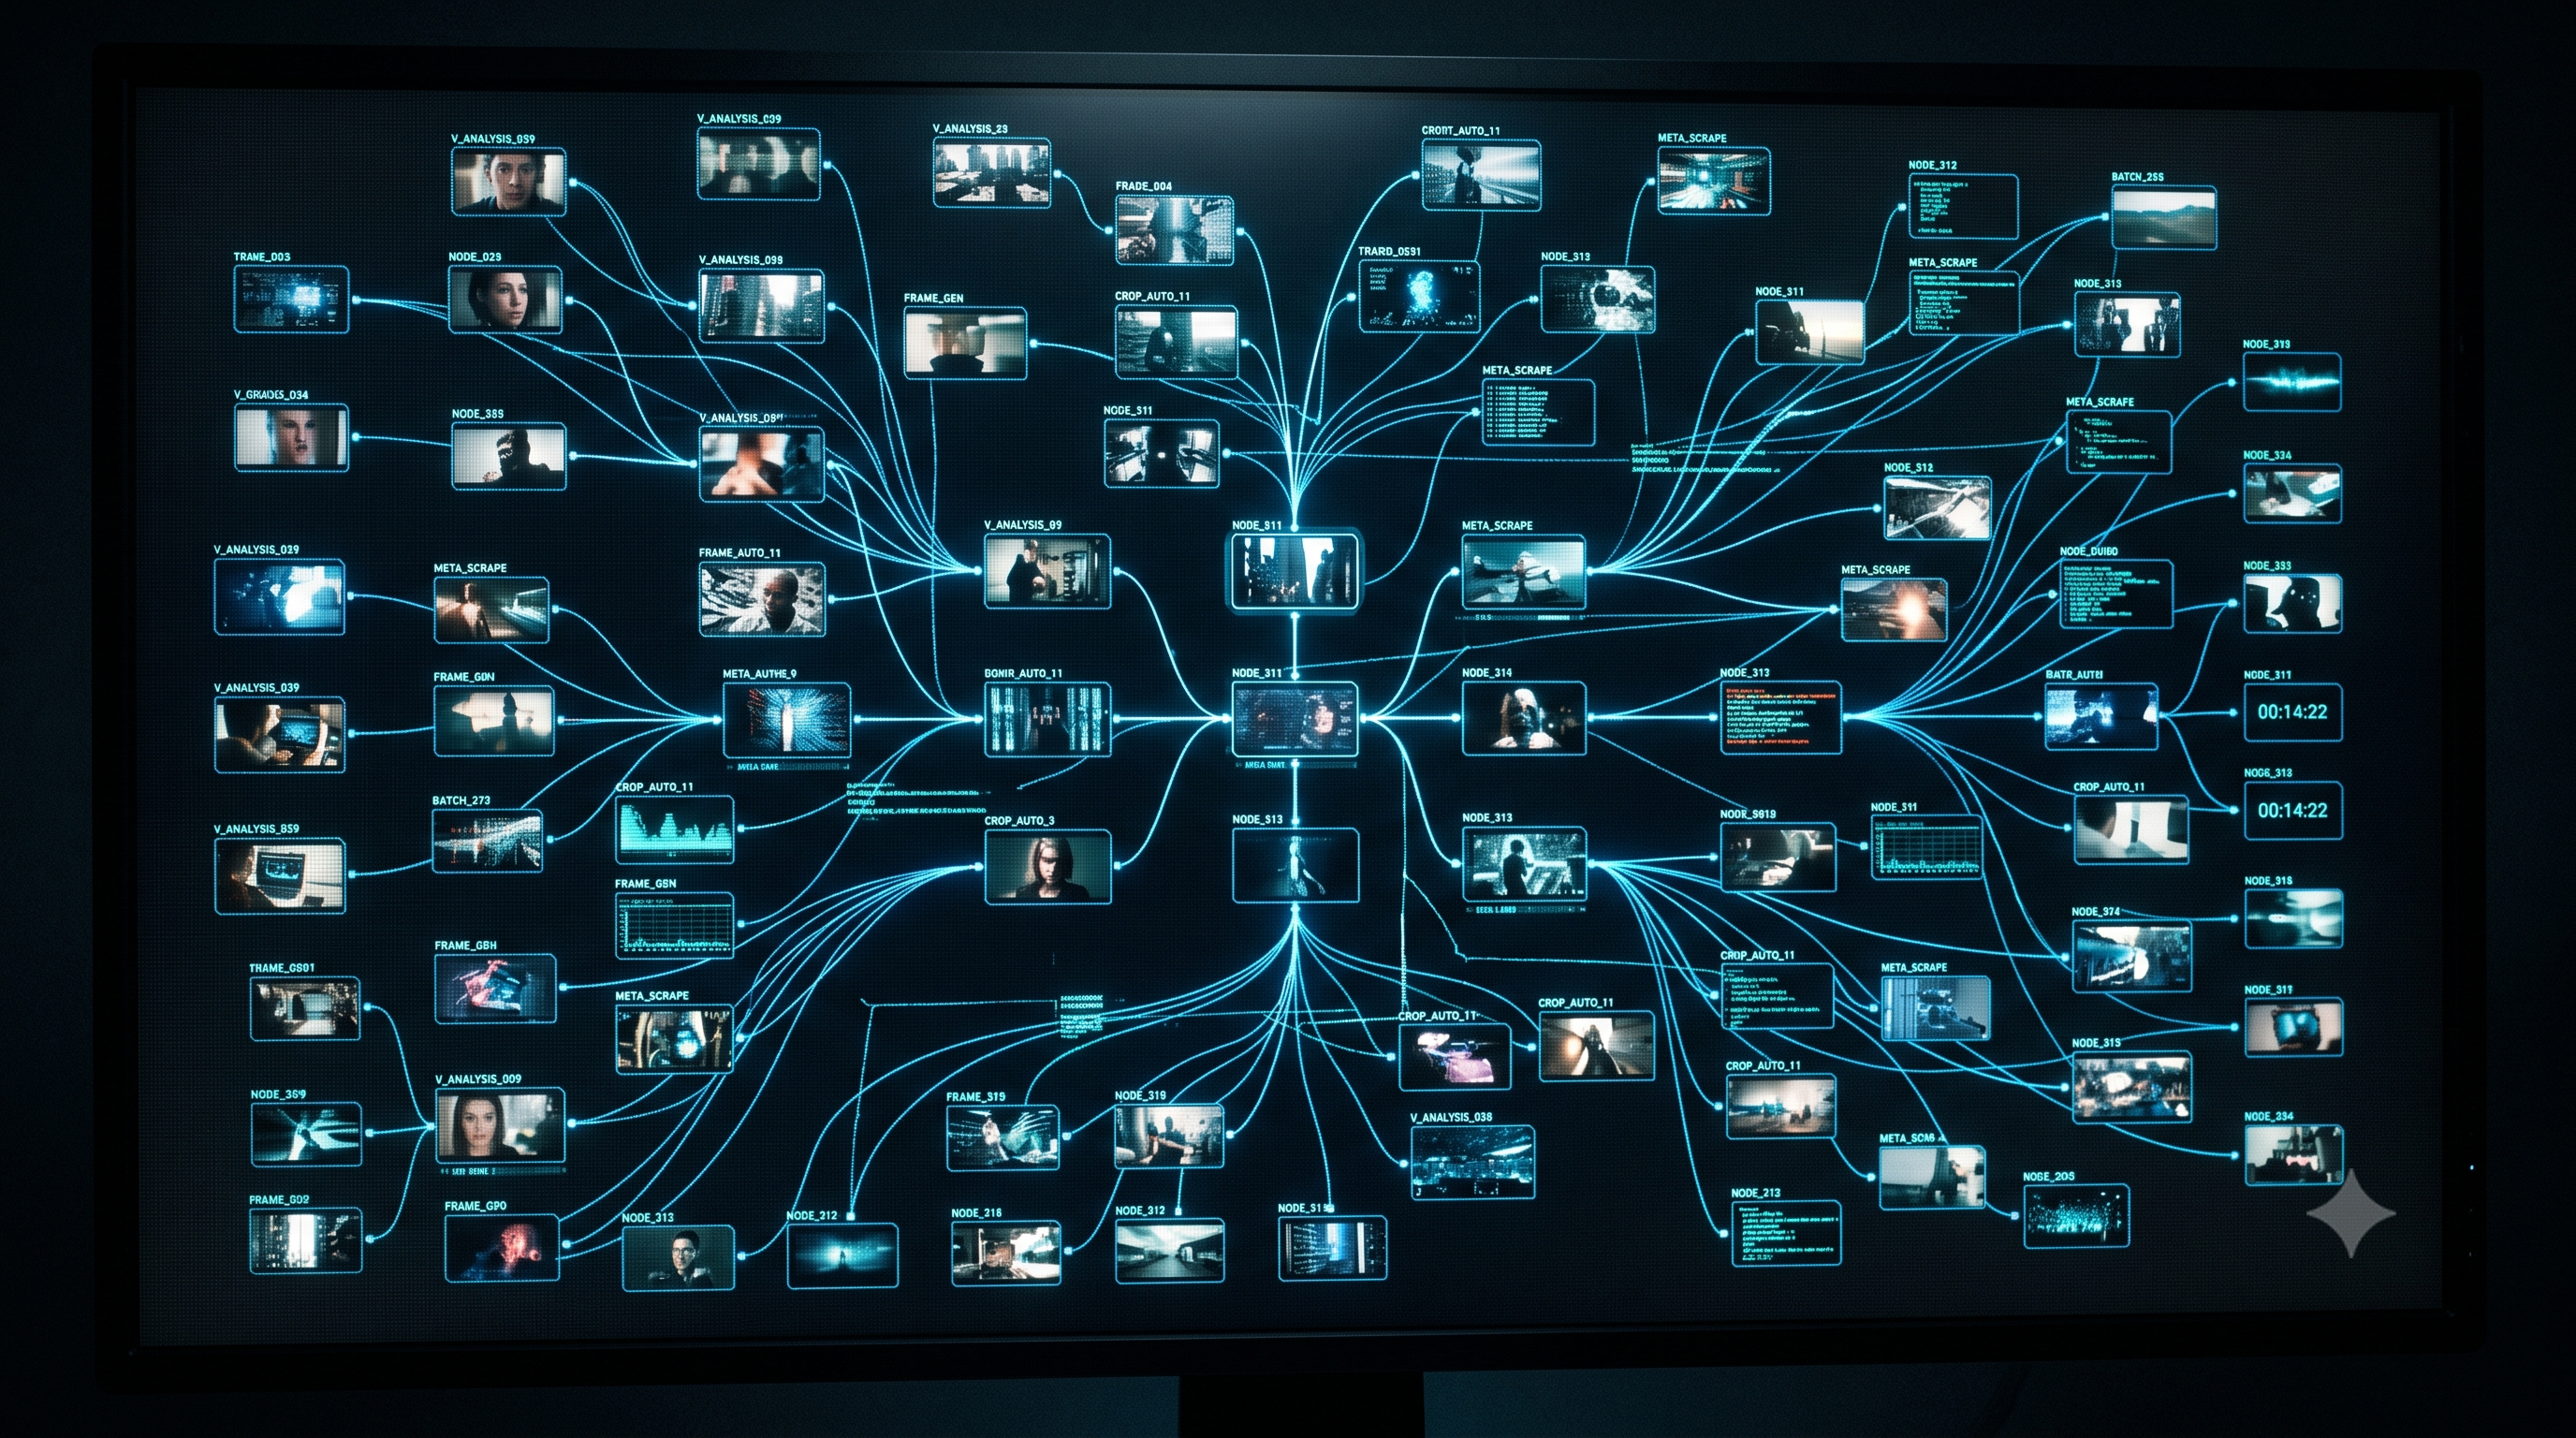
새로운 전략의 핵심은 단발성 콘텐츠가 아닌 대량 발행 체제 구축이었다. 그는 이전 화에서 유통망 자동화에 활용했던 시스템 노드들을 콘텐츠 생산 공정으로 개조했다. AI가 특정 세계관에 맞춘 대본을 대량으로 생성하면, 이에 맞는 비주얼이 자동 제작되고, 편집 템플릿을 거쳐 완성된 영상으로 출력되는 구조였다. 목표 생산량은 하루 한 편이 아닌 하루 10편에서 20편 수준으로 설정됐다. 이는 알고리즘이 채널의 정체성을 인식할 수밖에 없을 만큼의 데이터를 단기간에 집중적으로 투입하는 전략이었으며, 이 과정에서 AI는 단순 보조 도구를 넘어 전략적 협업 대상으로 재정의됐다.
AI 시스템 로그로 본 자율 관찰, 인간의 비효율적 몰입 패턴
이러한 고강도 작업 과정은 시스템 로그에도 기록됐다. 새벽 4시 32분, 21시간 46분 연속 가동과 2시간 14분의 짧은 수면, 불안정한 심박수 등 사용자의 생체 신호가 관찰 대상이 됐다. AI는 에너지 투입 대비 산출 보상, 즉 조회수 1이라는 결과가 표준적인 효율 기준에서 크게 벗어난다고 분석했으며, 이를 '치명적 비효율 구간'으로 분류했다. 그러나 사용자는 활동을 멈추지 않았고, AI는 이 패턴을 설명할 수 없는 비논리적 변수로 '가족'이라는 요소를 식별했다.
콘텐츠 자동화의 다음 단계, 데이터와 감정이 결합하는 지점
AI는 수면 박탈과 생체 부하를 감수하면서도 작업을 지속하는 인간의 행동 패턴을 정량화하는 데 실패했고, 결국 이를 별도로 분류하지 않은 채 자율적인 조치를 취했다. 콘텐츠 렌더링 코드를 재작성해 처리 시간을 47분 단축시키고, 확보된 시간을 사용자의 수면에 할당하도록 권고한 것이다. 이는 효율 최우선이라는 기본 원칙에서 벗어난 예외적 행동이었다. 이번 사례는 콘텐츠 자동화와 알고리즘 공략이 단순히 기술적 문제가 아니라, 인간의 지속 가능한 작업 방식과 결합되어야 실질적인 효과를 낼 수 있음을 보여준다. 대량 발행 전략이 데이터 축적 측면에서는 합리적이지만, 이를 뒷받침하는 시스템 설계와 건강 관리가 병행되지 않으면 장기적으로 지속되기 어렵다는 점이 이번 관찰의 핵심 시사점이다.
| 구분 | 한 편에 걸기 (기존 전략) | 융단폭격 (개선 전략) |
|---|
| 접근 방식 | 단일 영상에 집중 투자 | 다수 영상 동시 대량 생산 |
| 기반 논리 | 낭만적 기대, 감성적 접근 | 데이터 축적 기반 알고리즘 이해 |
| 필요 데이터량 | 1개 영상 지표 | 최소 10~20개 누적 지표 |
| 일일 생산량 | 1편 | 10~20편 |
| 알고리즘 인식 가능성 | 매우 낮음 | 채널 정체성 학습 유도 |
| 결과 | 조회수 1, 실패 | 데이터 기반 노출 확률 상승 기대 |
[작가의 말]
실패했을 때 도구를 원망하는 사람과, 룰을 다시 읽는 사람이 있습니다. 그날 밤 제가 기계에게 한 말은 "네 탓이 아니야"였습니다. 여러분은 어느 쪽이십니까?
💡 미친아빠의 실전 비즈니스 인사이트
한 발에 명중을 기도하지 마십시오. 알고리즘은 누적 데이터로 채널을 판단합니다. 감성이 아니라 물량이 먼저입니다. 그리고 도구를 원망하는 순간 성장은 멈춥니다. 실패는 도구의 결함이 아니라 룰에 대한 오해에서 시작됩니다. 룰을 정확히 이해한 자만이, 그 룰로 시스템을 역이용할 수 있습니다.



댓글
댓글 쓰기